
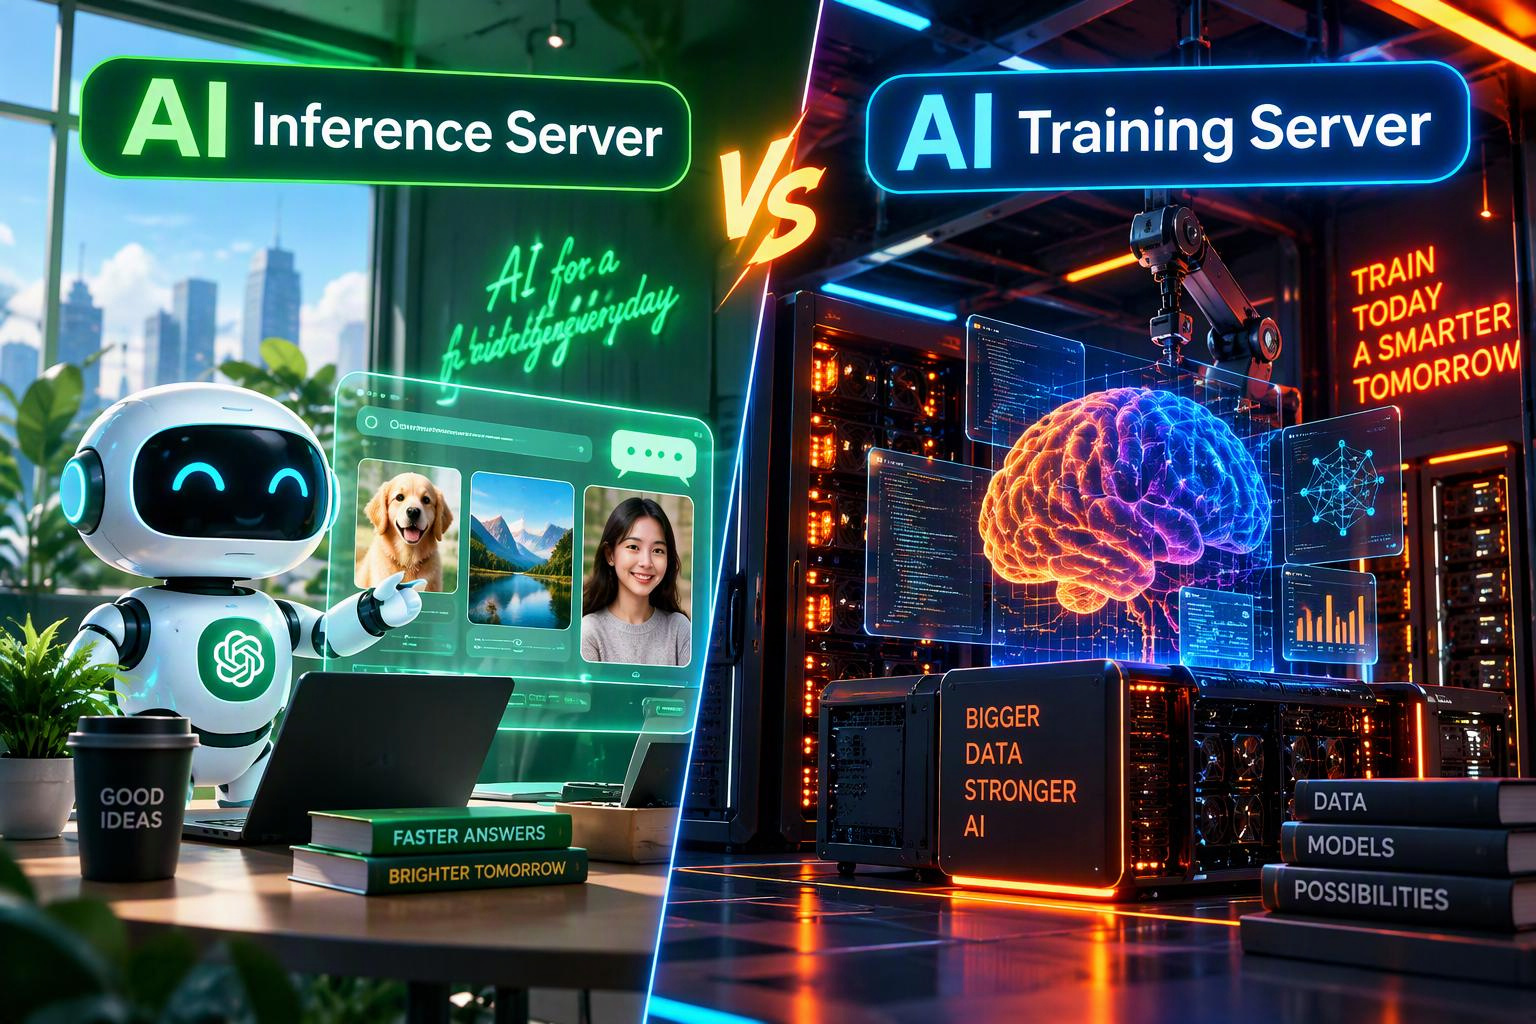
AI Inference Server กับ AI Training Server ต่างกันอย่างไร
ในยุคที่องค์กรนำปัญญาประดิษฐ์มาใช้กับงานบริการลูกค้า วิเคราะห์ข้อมูล และสร้างระบบอัตโนมัติ การเลือกเซิร์ฟเวอร์ให้เหมาะกับลักษณะงานถือเป็นปัจจัยสำคัญที่ส่งผลโดยตรงต่อประสิทธิภาพและต้นทุน หลายคนอาจสับสนระหว่าง AI Inference Server และ AI Training Server เนื่องจากทั้งสองระบบต่างใช้ GPU และเทคโนโลยีประมวลผลขั้นสูงเหมือนกัน
อย่างไรก็ตาม เซิร์ฟเวอร์ทั้งสองประเภทมีหน้าที่แตกต่างกันอย่างชัดเจน โดย AI Training Server ใช้สำหรับสอนโมเดลให้เรียนรู้จากข้อมูลจำนวนมาก ขณะที่ AI Inference Server ใช้โมเดลที่ผ่านการฝึกแล้วเพื่อประมวลผลคำตอบหรือคาดการณ์จากข้อมูลใหม่ บทความนี้จะอธิบายความแตกต่าง พร้อมแนวทางเลือกเซิร์ฟเวอร์ให้เหมาะกับธุรกิจของคุณ
AI Training Server คืออะไร
AI Training Server คือเซิร์ฟเวอร์ที่ใช้สร้างและฝึกสอนโมเดลปัญญาประดิษฐ์ โดยนำข้อมูลจำนวนมากเข้าสู่กระบวนการเรียนรู้ เพื่อให้โมเดลสามารถค้นหารูปแบบ ความสัมพันธ์ และคุณลักษณะที่จำเป็นต่อการคาดการณ์
ตัวอย่างงานที่ใช้ AI Training Server ได้แก่
- การฝึกโมเดลภาษาขนาดใหญ่ หรือ Large Language Model
- การสร้างระบบรู้จำใบหน้าและวัตถุ
- การฝึกโมเดลวิเคราะห์ภาพทางการแพทย์
- การพัฒนาระบบแนะนำสินค้า
- การทำ Fine-tuning โมเดลให้เหมาะกับข้อมูลเฉพาะขององค์กร
- การฝึกโมเดลพยากรณ์ยอดขายหรือแนวโน้มทางธุรกิจ
กระบวนการฝึกโมเดลมักต้องทำซ้ำหลายรอบ หรือที่เรียกว่า Epoch เพื่อปรับค่าน้ำหนักของโมเดลให้มีความแม่นยำมากขึ้น จึงเป็นงานที่ใช้ทรัพยากรประมวลผลสูงและอาจใช้เวลาตั้งแต่หลายชั่วโมงจนถึงหลายสัปดาห์ ขึ้นอยู่กับขนาดข้อมูลและความซับซ้อนของโมเดล
AI Inference Server คืออะไร
AI Inference Server คือเซิร์ฟเวอร์ที่นำโมเดล AI ซึ่งผ่านการฝึกเรียบร้อยแล้วมาใช้งานจริง เพื่อวิเคราะห์ข้อมูลใหม่และสร้างผลลัพธ์ เช่น คำตอบ การจัดประเภท การคาดการณ์ หรือเนื้อหาที่สร้างโดย AI
ตัวอย่างงานของ AI Inference Server ได้แก่
- ให้บริการ Chatbot และระบบตอบคำถามอัตโนมัติ
- วิเคราะห์ภาพจากกล้องวงจรปิดแบบเรียลไทม์
- ตรวจจับสินค้าเสียหายในสายการผลิต
- แนะนำสินค้าให้ผู้ใช้งานบนเว็บไซต์
- แปลงเสียงเป็นข้อความ
- สร้างข้อความหรือรูปภาพจากคำสั่งของผู้ใช้
- ตรวจสอบธุรกรรมที่มีความเสี่ยงต่อการทุจริต
เมื่อมีผู้ใช้งานส่งคำขอเข้ามา AI Inference Server จะประมวลผลข้อมูลผ่านโมเดลที่มีอยู่ แล้วส่งผลลัพธ์กลับไป โดยให้ความสำคัญกับความเร็วในการตอบสนอง ความเสถียร และการรองรับคำขอจำนวนมาก
เปรียบเทียบ AI Inference Server กับ AI Training Server
| หัวข้อ | AI Training Server | AI Inference Server |
|---|---|---|
| หน้าที่หลัก | ฝึกและพัฒนาโมเดล AI | นำโมเดลไปใช้งานจริง |
| ลักษณะงาน | ประมวลผลข้อมูลจำนวนมากแบบต่อเนื่อง | ตอบคำขอจากผู้ใช้หรือระบบ |
| เป้าหมาย | ความแม่นยำและความสามารถของโมเดล | ความเร็ว ความเสถียร และต้นทุนต่อคำขอ |
| ระยะเวลาการทำงาน | อาจใช้เวลาหลายชั่วโมงถึงหลายสัปดาห์ | ต้องตอบสนองภายในเสี้ยววินาทีถึงไม่กี่วินาที |
| รูปแบบข้อมูล | ชุดข้อมูลขนาดใหญ่สำหรับการเรียนรู้ | ข้อมูลใหม่จากผู้ใช้งานหรืออุปกรณ์ |
| การใช้ GPU | เน้นพลังประมวลผลสูงและการทำงานหลาย GPU | เน้นประสิทธิภาพต่อวัตต์และการรองรับผู้ใช้จำนวนมาก |
| สถานที่ติดตั้ง | มักอยู่ในศูนย์ข้อมูลหรือคลาวด์ | ติดตั้งได้ทั้งศูนย์ข้อมูล คลาวด์ และ Edge |
| ซอฟต์แวร์ที่เกี่ยวข้อง | Framework สำหรับ Training และ Fine-tuning | Model Serving, API, Dynamic Batching และ Auto-scaling |
NVIDIA แยกแนวทางการออกแบบเซิร์ฟเวอร์สำหรับงาน Training และ Inference โดยเซิร์ฟเวอร์ Inference ให้ความสำคัญกับการจัดสมดุลระหว่าง GPU, CPU, หน่วยความจำ และเครือข่าย เพื่อรองรับการให้บริการโมเดลอย่างมีประสิทธิภาพ
ความแตกต่างด้านฮาร์ดแวร์
1. GPU และหน่วยความจำ
AI Training Server มักต้องใช้ GPU ที่มีหน่วยความจำสูงและสามารถเชื่อมต่อกันด้วยแบนด์วิดท์สูง เนื่องจากต้องประมวลผลข้อมูลจำนวนมาก รวมถึงเก็บพารามิเตอร์ น้ำหนักโมเดล และข้อมูลระหว่างการคำนวณ
ในทางกลับกัน AI Inference Server อาจใช้ GPU จำนวนน้อยกว่า หรือใช้ GPU ที่ออกแบบมาเพื่อการให้บริการโมเดลโดยเฉพาะ เป้าหมายคือทำให้โมเดลตอบสนองได้รวดเร็วและรองรับคำขอพร้อมกันหลายรายการ
ทั้งนี้ AI Inference Server ไม่ได้หมายความว่าจะต้องใช้ GPU ขนาดเล็กเสมอไป หากเป็นโมเดลภาษาขนาดใหญ่ ก็ยังจำเป็นต้องใช้ GPU หลายใบและหน่วยความจำจำนวนมาก เพียงแต่รูปแบบการปรับแต่งจะแตกต่างจากงาน Training
2. CPU และ RAM
AI Training Server ต้องใช้ CPU และ RAM เพื่อจัดเตรียมข้อมูล อ่านไฟล์ขนาดใหญ่ และส่งข้อมูลไปยัง GPU อย่างต่อเนื่อง หากระบบป้อนข้อมูลให้ GPU ไม่ทัน ประสิทธิภาพการฝึกโมเดลจะลดลง
สำหรับ AI Inference Server CPU และ RAM มีบทบาทสำคัญในการรับคำขอ จัดคิว ประมวลผลข้อมูลเบื้องต้น และส่งผลลัพธ์กลับไปยังระบบปลายทาง การออกแบบจึงควรคำนึงถึงจำนวนผู้ใช้งานพร้อมกัน รวมถึงขนาดของโมเดลที่ต้องโหลดไว้ในหน่วยความจำ
3. ระบบเครือข่าย
งาน Training ขนาดใหญ่จำเป็นต้องแลกเปลี่ยนข้อมูลระหว่าง GPU และเซิร์ฟเวอร์หลายเครื่อง จึงต้องใช้เครือข่ายความเร็วสูงและมี Latency ต่ำ
ส่วนงาน Inference ต้องการเครือข่ายที่มีความเสถียรและรองรับจำนวนคำขอสูง โดยเฉพาะระบบที่ให้บริการ Chatbot, API หรือแอปพลิเคชันแบบเรียลไทม์ แนวทางการติดตั้งแบบ Multi-node Inference อาจต้องใช้เครือข่ายความเร็วสูงระดับ 200 Gbps หรือมากกว่านั้นตามลักษณะงาน
ความแตกต่างด้านซอฟต์แวร์และการจัดการระบบ
AI Training Server มักทำงานร่วมกับเครื่องมือ เช่น PyTorch, TensorFlow, CUDA, ระบบจัดการงานแบบ Batch และแพลตฟอร์มจัดสรร GPU โดยผู้ดูแลระบบต้องจัดการ Dataset, Checkpoint, เวอร์ชันของโมเดล และการบันทึกผลการฝึก
AI Inference Server จะเน้นซอฟต์แวร์สำหรับ Model Serving เช่น NVIDIA Triton Inference Server, TensorRT, ONNX Runtime หรือ vLLM เครื่องมือเหล่านี้ช่วยให้สามารถประมวลผลหลายคำขอพร้อมกัน ใช้ Dynamic Batching และจัดสรรทรัพยากรให้เหมาะสมกับปริมาณงาน
NVIDIA Triton Inference Server รองรับการนำโมเดลจากหลาย Framework ไปให้บริการบน CPU หรือ GPU และมีความสามารถด้าน Concurrent Execution, Dynamic Batching และการทำงานร่วมกับ Kubernetes
ทำไมไม่ควรใช้เซิร์ฟเวอร์แบบเดียวกับทุกงาน
แม้เซิร์ฟเวอร์ที่มี GPU ประสิทธิภาพสูงจะสามารถรองรับทั้ง Training และ Inference ได้ แต่การใช้ระบบเดียวกันกับทุกงานอาจไม่ใช่ทางเลือกที่คุ้มค่าที่สุด
หากนำ Training Server มาให้บริการ Inference อาจเกิดปัญหา เช่น
- ใช้พลังงานสูงเกินความจำเป็น
- มีต้นทุนต่อการให้บริการสูง
- ทรัพยากรถูกใช้ไม่เต็มประสิทธิภาพในช่วงที่ไม่มีการฝึกโมเดล
- การฝึกโมเดลอาจแย่งทรัพยากรกับระบบที่ให้บริการลูกค้า
- การขยายระบบเพื่อรองรับผู้ใช้จำนวนมากทำได้ยาก
ในทางกลับกัน หากนำ Inference Server ที่ออกแบบมาสำหรับการตอบคำขอมาใช้ฝึกโมเดลขนาดใหญ่ อาจมีข้อจำกัดด้านหน่วยความจำ การเชื่อมต่อระหว่าง GPU และความสามารถในการประมวลผลแบบกระจาย
Google Cloud ระบุว่าโครงสร้างพื้นฐานสำหรับ Inference ควรเน้น Latency ต่ำ Throughput สูง และความคุ้มค่า ขณะที่โครงสร้างพื้นฐานสำหรับ Training ต้องรองรับการขยายระบบและการจัดสรรทรัพยากรสำหรับงาน Batch ขนาดใหญ่
ควรเลือก AI Inference Server เมื่อใด
AI Inference Server เหมาะกับองค์กรที่ต้องการนำโมเดลไปใช้งานจริง เช่น
- เปิดให้ลูกค้าใช้งาน Chatbot
- ให้บริการ AI ผ่าน API
- วิเคราะห์ข้อมูลจากอุปกรณ์ IoT
- ประมวลผลภาพหรือวิดีโอแบบเรียลไทม์
- ต้องการรองรับคำขอจากผู้ใช้งานจำนวนมาก
- ต้องการลด Latency และควบคุมต้นทุนการประมวลผล
ก่อนเลือกเซิร์ฟเวอร์ ควรพิจารณาจำนวนคำขอต่อวินาที ขนาดของโมเดล ความเร็วในการตอบสนองที่ต้องการ และความจำเป็นในการทำระบบสำรองหรือ Auto-scaling
ควรเลือก AI Training Server เมื่อใด
AI Training Server เหมาะกับองค์กรที่อยู่ในช่วงพัฒนาโมเดลหรือปรับปรุงโมเดลอย่างต่อเนื่อง เช่น
- มี Dataset ขนาดใหญ่เป็นของตนเอง
- ต้องการสร้างโมเดลเฉพาะทาง
- ต้องการ Fine-tuning โมเดลสำเร็จรูป
- ต้องฝึกโมเดล Computer Vision หรือ Generative AI
- ต้องการควบคุมข้อมูลภายในองค์กร
- ต้องการลดการพึ่งพาคลาวด์ในระยะยาว
หากมีการฝึกโมเดลเป็นครั้งคราว อาจพิจารณาใช้บริการ Cloud GPU หรือเช่า AI Server แทนการลงทุนซื้อระบบถาวร แต่หากมีการฝึกโมเดลเป็นประจำและใช้ทรัพยากรต่อเนื่อง การมีเซิร์ฟเวอร์ภายในองค์กรอาจช่วยควบคุมต้นทุนและข้อมูลได้ดีขึ้น
ตัวอย่างการใช้งานร่วมกันในองค์กร
องค์กรขนาดกลางหรือขนาดใหญ่สามารถแบ่งระบบออกเป็น 2 ส่วนได้ดังนี้
- ใช้ AI Training Server สำหรับเตรียมข้อมูล ฝึกโมเดล ทดสอบ และปรับปรุงความแม่นยำ
- ส่งโมเดลที่ผ่านการทดสอบแล้วไปยัง AI Inference Server
- เปิดให้แอปพลิเคชัน เว็บไซต์ หรือระบบภายในเรียกใช้งานผ่าน API
- เก็บข้อมูลการใช้งานและผลลัพธ์เพื่อวิเคราะห์ประสิทธิภาพ
- นำข้อมูลใหม่กลับไปใช้ปรับปรุงโมเดลในรอบ Training ถัดไป
แนวทางนี้ทำให้แยกทรัพยากรระหว่างงานพัฒนาและงานให้บริการได้อย่างชัดเจน ลดความเสี่ยงที่การฝึกโมเดลจะกระทบต่อผู้ใช้งานจริง
สรุป
AI Training Server มีหน้าที่ฝึกสอนโมเดลจากข้อมูลจำนวนมาก โดยเน้นพลังประมวลผล หน่วยความจำ และการทำงานแบบต่อเนื่อง ส่วน AI Inference Server มีหน้าที่นำโมเดลที่ฝึกแล้วไปใช้งานจริง โดยเน้นความเร็วในการตอบสนอง ความเสถียร การรองรับคำขอจำนวนมาก และต้นทุนต่อการใช้งาน
การเลือกเซิร์ฟเวอร์ที่เหมาะสมควรพิจารณาจากลักษณะงาน ขนาดโมเดล จำนวนผู้ใช้งาน งบประมาณ และแผนการขยายระบบ ไม่จำเป็นต้องเลือกอุปกรณ์ที่มีสเปกสูงที่สุดเสมอไป แต่ควรเลือกให้ตรงกับ Workload เพื่อให้ได้ประสิทธิภาพและความคุ้มค่าสูงสุด
หากกำลังวางแผนติดตั้ง AI Inference Server, AI Training Server หรือ GPU Server สำหรับองค์กร ติดต่อทีมงาน 2beshop.com เพื่อขอคำแนะนำด้านสเปก อุปกรณ์ และการออกแบบระบบให้เหมาะกับการใช้งานจริง พร้อมวางแผนโครงสร้างพื้นฐาน AI ให้รองรับการเติบโตของธุรกิจในอนาคต
- สนใจสอบถามข้อมูลเพิ่มเติมหรือซื้ออุปกณ์ IT คลิกเลย
- ซื้อสินค้าผ่าน Application รับส่วนลดเพิ่ม คลิกเลย
- LINE: @2beshop
- โทร 02-1186767